Quel PC pour l'IA ?
Carte graphique, VRAM, RAM, processeur : ce qui compte vraiment pour faire tourner un ChatGPT privé, Stable Diffusion ou entraîner vos propres modèles chez vous. Et un simulateur pour trouver la configuration juste.
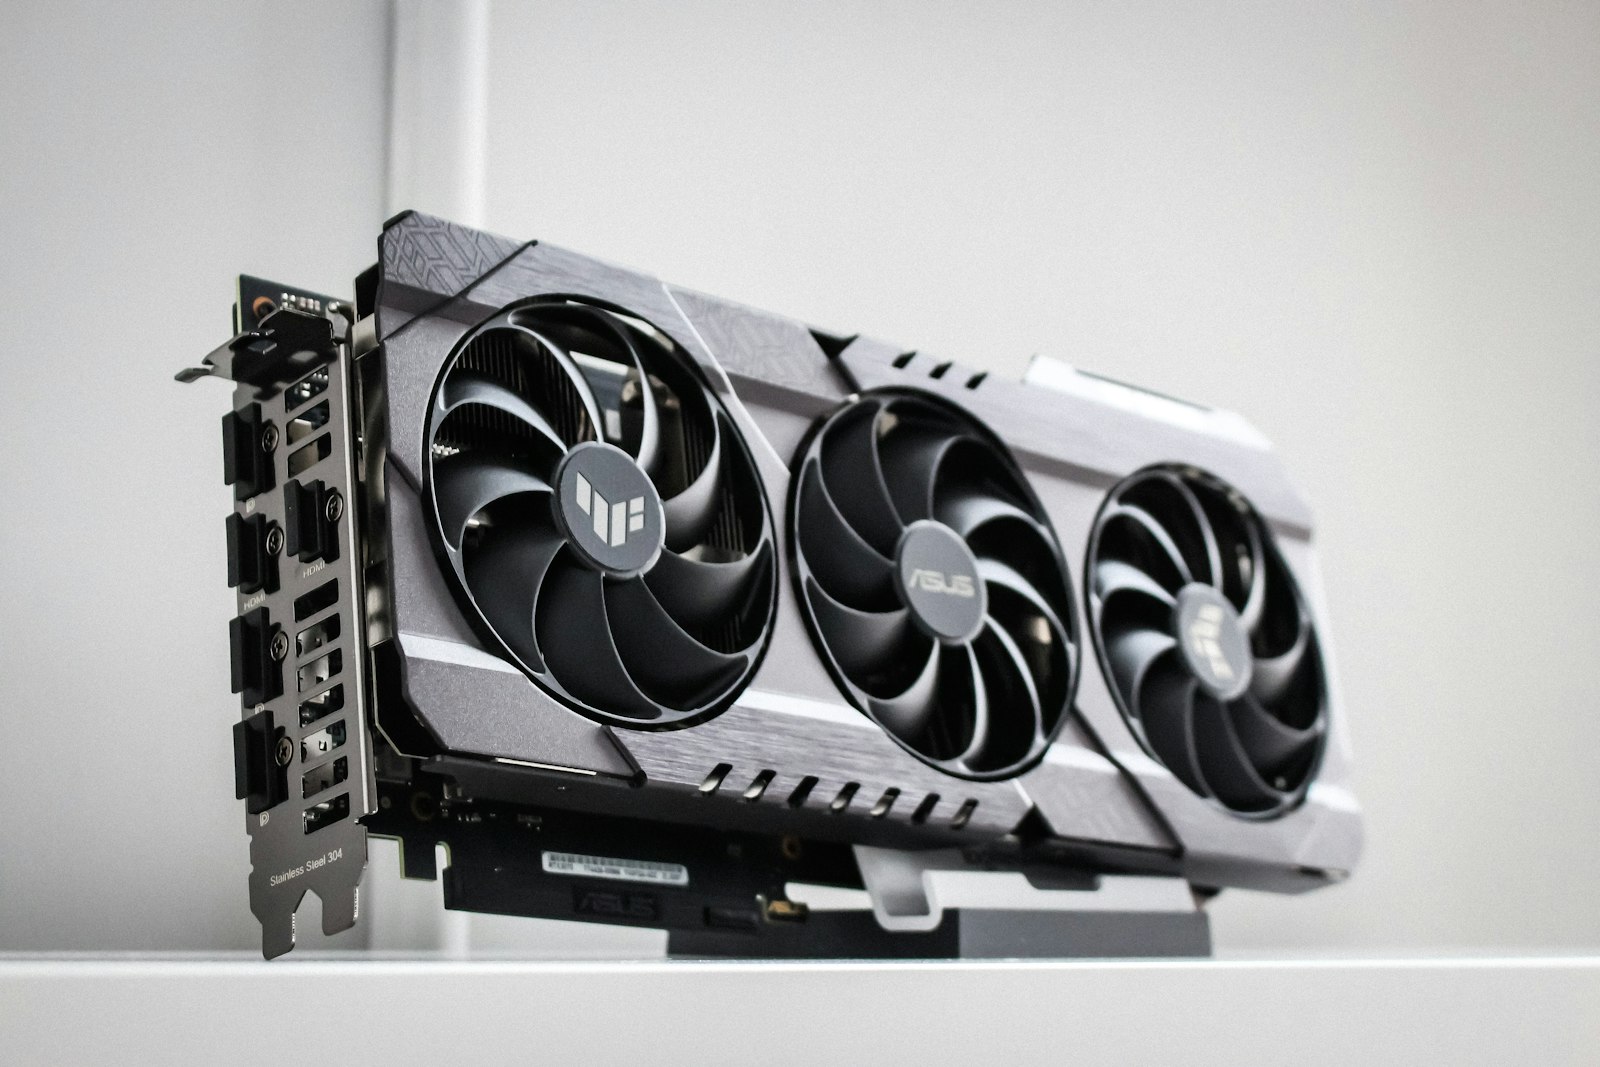
La carte graphique fait (presque) tout
Pour l'IA locale, le GPU NVIDIA et sa mémoire vidéo comptent plus que le processeur. 16 Go de VRAM ouvrent les modèles 14B confortables, 24 à 32 Go les modèles 30B et la génération vidéo.
Une IA, c'est d'abord une affaire de mémoire
Pour écrire chaque mot, le modèle relit l'intégralité de ses milliards de paramètres. La question n'est donc pas « quelle puissance ? » mais « où tient le modèle, et à quelle vitesse peut-on le relire ? ».
Les cartes graphiques pour l'IA en 2026
NVIDIA reste le standard grâce à CUDA, que tous les logiciels d'IA supportent en priorité. Deux familles : les GeForce RTX 50 (grand public) et les RTX PRO Blackwell (professionnelles, mémoire ECC, fonctionnement 24 h/24).
| Carte | VRAM | Bande passante | Modèle max (4 bits) | Pour qui ? |
|---|---|---|---|---|
| RTX 5060 Ti | 16 Go | 448 Go/s | 8 à 14B | Débuter : chat, images, transcription |
| RTX 5070 Ti | 16 Go | 896 Go/s | 14B (rapide) | Créateurs, IA au quotidien |
| RTX 5080 | 16 Go | 960 Go/s | 14B (rapide) | Gaming + IA |
| RTX 5090 | 32 Go | 1 792 Go/s | 32B | La plus rapide du grand public |
| RTX PRO 5000 Blackwell | 48 Go | 1 344 Go/s | 32B + long contexte | Pro, mémoire ECC |
| RTX PRO 6000 Blackwell Best-seller IA | 96 Go | 1 792 Go/s | 70B à 120B | La référence de la workstation IA |
| 2× RTX PRO 6000 | 192 Go | 2 × 1 792 Go/s | 120B à 235B | Serveur d'équipe, fine-tuning |
| 4× RTX PRO 6000 | 384 Go | 4 × 1 792 Go/s | 400B+ (hybride) | Géants open source, entraînement |
« Modèle max » : taille de modèle tenant entièrement en VRAM avec une marge pour le contexte. Les modèles MoE peuvent dépasser ces tailles en mode hybride GPU + RAM.
Capacité contre vitesse
Chaque solution se place sur deux axes : la quantité de mémoire (quels modèles on peut charger) et sa vitesse (à quelle allure ils répondent). Survolez les points.
Le bon réflexe
Les mini-PC à mémoire unifiée (DGX Spark, Ryzen AI Max) et les Mac chargent de gros modèles mais les font tourner lentement. Les GPU NVIDIA sont 2 à 7 fois plus rapides, et s'additionnent pour gagner en capacité.
Trouvez votre configuration
Cochez vos usages et le nombre d'utilisateurs : on calcule la mémoire nécessaire et la machine adaptée, sans la surdimensionner.
Vos usages
Notre recommandation
Le montage d'un GPU, pas à pas
Retrait des protections, insertion PCIe, alimentation 12V-2x6 : les gestes de l'atelier Forge PC Elite pour installer une RTX en toute sécurité.
Les autres composants qui comptent
Une carte graphique de 8 000 € mal entourée, c'est une Formule 1 avec des pneus de vélo.
Processeur
Ryzen 9 pour 1 GPU ; Threadripper ou Xeon W dès 2 GPU pour leurs lignes PCIe (jusqu'à 128). Les cœurs accélèrent la préparation des données et les modèles en RAM.
RAM DDR5
Au moins 2× la VRAM. 64 Go pour débuter, 256 à 512 Go ECC pour les gros modèles MoE. Le nombre de canaux (2, 4 ou 8) multiplie la vitesse.
SSD NVMe PCIe 5.0
Les modèles pèsent de 5 à 500 Go. 4 To minimum conseillés ; un SSD Gen5 charge un modèle de 40 Go en moins de 5 secondes.
Alimentation
Une RTX PRO 6000 consomme jusqu'à 600 W. Comptez 1 200 W pour un GPU, 1 600 W et plus pour deux, en 80 PLUS Platinum ou Titanium.
Refroidissement
L'IA fait travailler le GPU à 100 % pendant des heures. Flux d'air soigné, cartes « blower » en multi-GPU, voire watercooling custom.
Réseau & OS
10 GbE pour servir l'équipe. Linux (Ubuntu) pour la performance et vLLM, Windows + WSL2 pour la polyvalence : nous installons les deux.
PC IA, Mac, mini-PC ou cloud ?
Workstation NVIDIA
RTX 5090 ou RTX PRO, Linux/Windows
- La plus rapide (1 792 Go/s par GPU)
- Évolutive : 1 à 4 GPU
- Compatible avec 100 % des outils (CUDA)
- Entraînement et fine-tuning
- Encombrement, consommation
Mac Studio
Puce Apple, mémoire unifiée
- Jusqu'à 512 Go de mémoire unifiée
- Silencieux et sobre
- 2 à 3× plus lent qu'un GPU NVIDIA
- Pas de CUDA, entraînement limité
- Non évolutif
Mini-PC IA
DGX Spark, Ryzen AI Max+
- 128 Go dans une petite boîte
- Idéal pour prototyper
- Bande passante faible (~256-273 Go/s)
- Lent sur les gros modèles
- Non évolutif
Cloud GPU
Location à l'heure
- Aucun investissement initial
- Puissance quasi illimitée
- Coût qui explose à l'usage quotidien
- Vos données sortent de chez vous
- Dépendance au fournisseur
Combien coûte vraiment le cloud ? Simulez la rentabilité d'une workstation →
8 outils gratuits pour démarrer
Tous open source ou gratuits. Nos machines sont livrées avec les pilotes NVIDIA, CUDA et, sur demande, Ollama, LM Studio ou ComfyUI déjà installés.
Une commande pour télécharger et lancer Llama, Qwen, Mistral…
LM Studio ↗DébutantInterface graphique façon ChatGPT, 100 % locale.
Open WebUI ↗ÉquipeVotre ChatGPT privé pour toute l'entreprise, en réseau.
ComfyUI ↗CréationGénération d'images et de vidéos par nœuds (FLUX, Wan…).
llama.cpp ↗AvancéLe moteur d'inférence le plus efficace, CPU + GPU.
vLLM ↗ServeurServir un modèle à des dizaines d'utilisateurs simultanés.
Unsloth ↗EntraînementFine-tuning 2× plus rapide avec moins de VRAM.
AnythingLLM ↗DocumentsDiscutez avec vos PDF et documents internes (RAG).
Les 6 erreurs les plus coûteuses
Une carte rapide de 12 Go ne chargera jamais un modèle de 70B. La VRAM décide de ce que vous pouvez faire.
Avec 32 Go de RAM, impossible de charger les gros modèles ou de travailler confortablement à côté.
Deux GPU différents se brident mutuellement. Mieux vaut des cartes identiques.
Les pics de consommation des GPU modernes font redémarrer les machines mal alimentées.
Un GPU qui chauffe baisse sa fréquence : vous perdez 20 à 30 % de performance.
Inutile de viser 4 GPU pour un assistant de rédaction : un conseil honnête vous fait économiser des milliers d'euros.
Des PC pensés pour l'IA, montés à Labège (31)
Plus de VRAM, une alimentation dimensionnée, un refroidissement silencieux : la recette d'une IA locale fluide.
Modèles 70B+, fine-tuning, plusieurs utilisateurs ?
Notre demande de devis guidée calcule la VRAM nécessaire et propose la bonne classe de machine : bi-GPU, RTX PRO 6000, serveur rack multi-GPU.
Les workstations IA Forge PC Elite
Assemblées à la main et testées en charge dans l'atelier de Labège, près de Toulouse. Garantie 2 ans, livrées prêtes à l'emploi.
Le Forge Rapid X
- AMD Ryzen 9
- GPU NVIDIA RTX 16 Go
- Ollama, LM Studio, ComfyUI
- Modèles jusqu'à ~14B
Le Forge Nightfall
- Intel Core Ultra 7 265KF
- RTX 5070 Ti 16 Go
- 64 Go de RAM
- Images, montage, IA générative
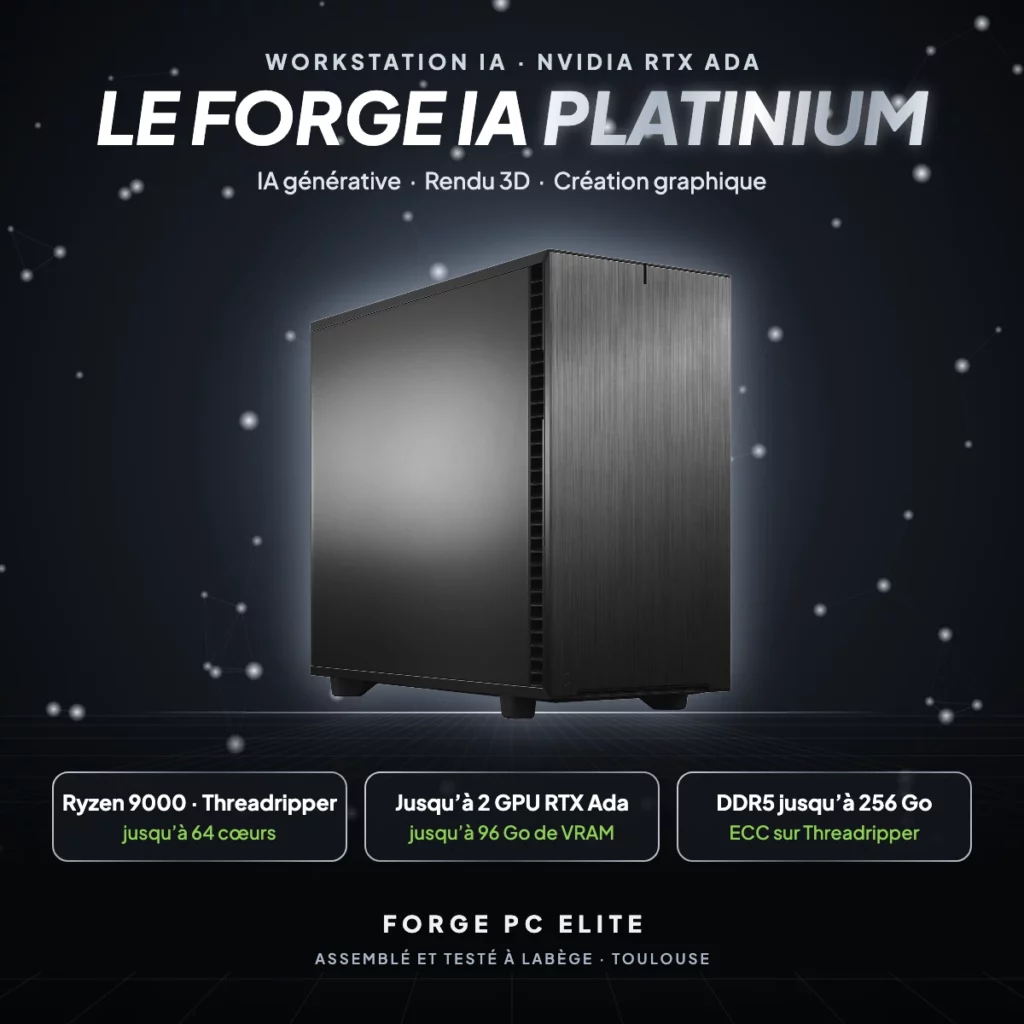
Le Forge IA Platinium
- Ryzen 9 à Threadripper 9980X
- Jusqu'à 2 RTX PRO · 96 Go VRAM ECC
- Jusqu'à 256 Go DDR5
- Modèles 32B à 70B
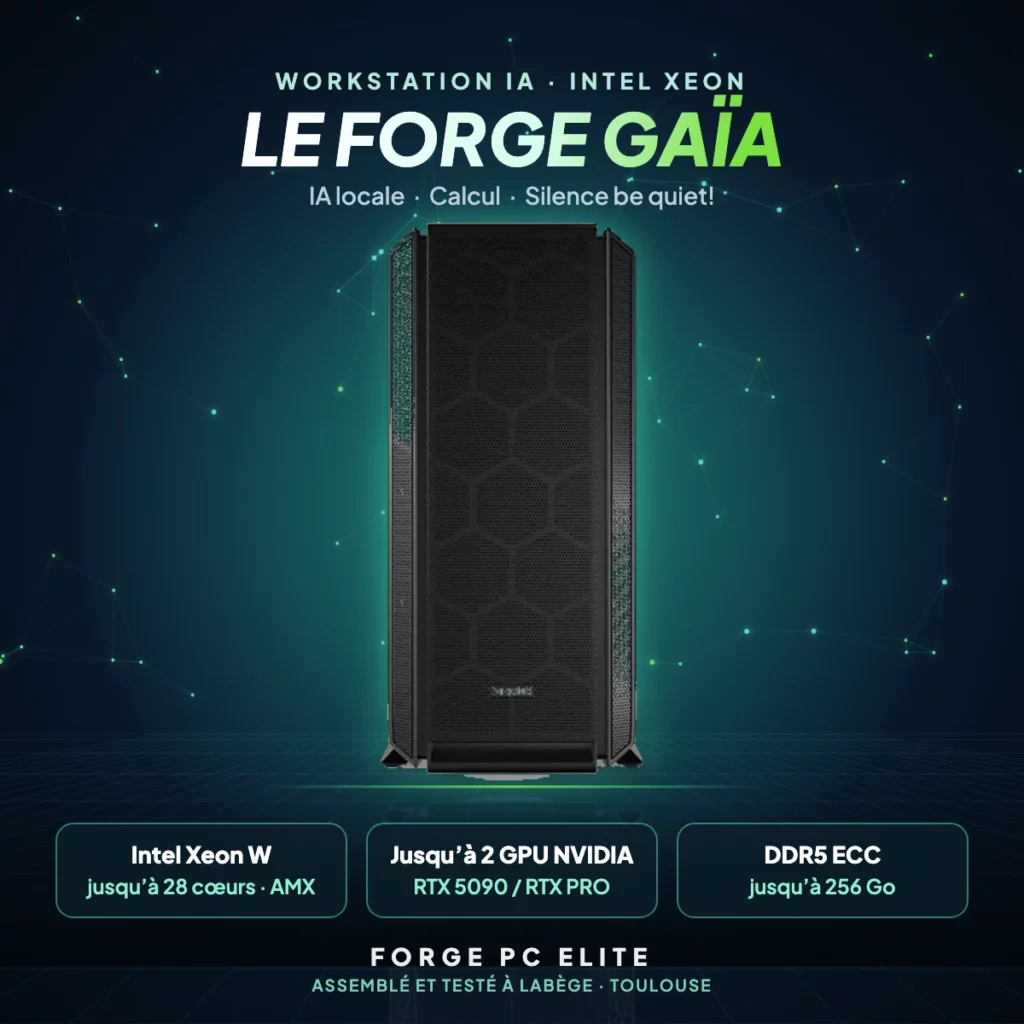
Le Forge Gaïa
- Xeon W jusqu'à 28 cœurs
- Jusqu'à 2 GPU RTX 5090 / RTX PRO
- 256 Go DDR5 ECC
- Instructions AMX
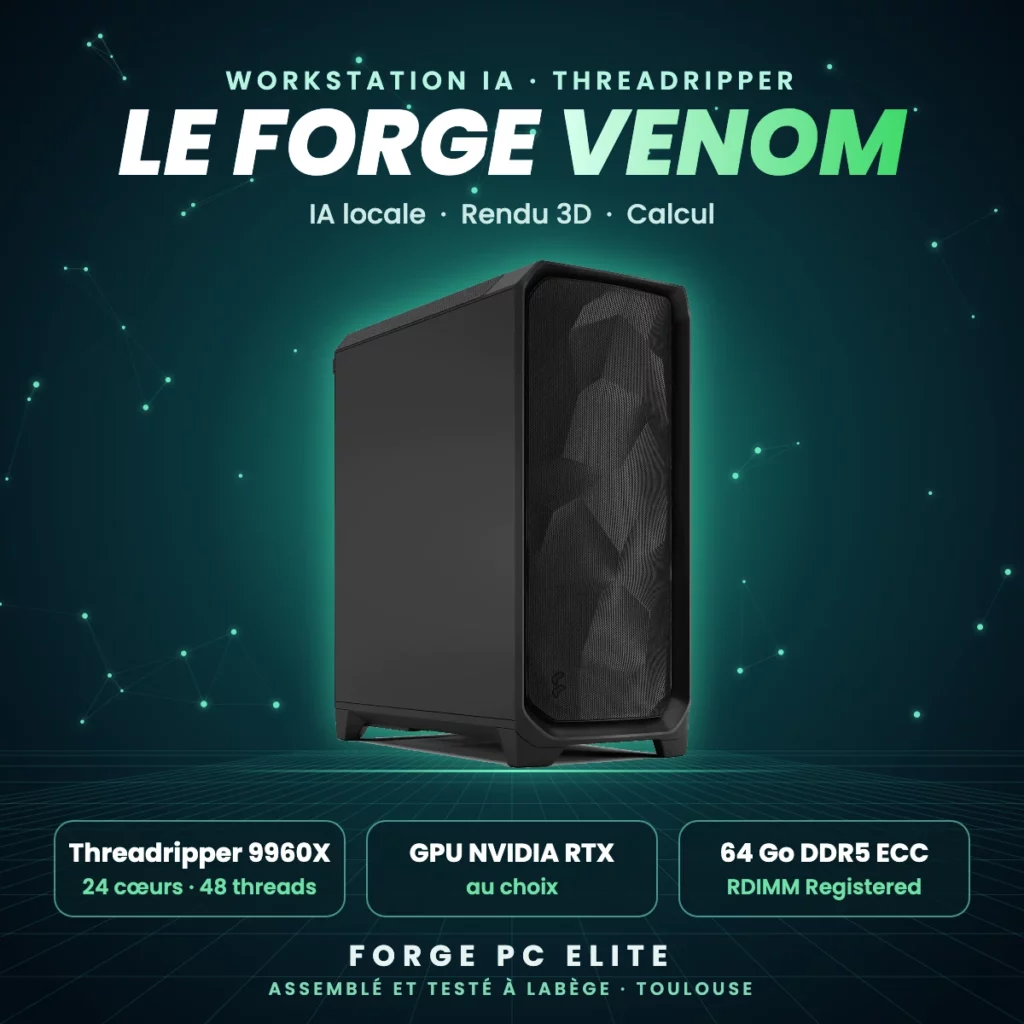
Le Forge Venom
- AMD Threadripper 9000
- De la RTX 5060 à 2× RTX 5090
- Jusqu'à 256 Go DDR5 ECC
- L'IA locale sans compromis
Workstation Pro Rack
- Threadripper PRO 9000 WX, 96 cœurs
- 2× RTX 5090 ou RTX PRO
- Jusqu'à 512 Go DDR5 ECC 8 canaux
- Le serveur IA de l'équipe
Questions fréquentes
Quel est le minimum pour faire tourner une IA en local ?
Une carte NVIDIA avec 16 Go de VRAM (RTX 5060 Ti 16 Go ou RTX 5070 Ti), 64 Go de RAM et un SSD NVMe de 2 To. Vous ferez tourner des modèles de 8 à 14 milliards de paramètres, FLUX pour les images et Whisper pour la transcription.
Combien de VRAM pour Llama 70B ou gpt-oss-120b ?
Environ 42 Go pour un modèle 70B en 4 bits, et 65 Go environ pour gpt-oss-120b : une RTX PRO 6000 de 96 Go les fait tourner entièrement en VRAM, avec de la marge pour un long contexte.
Une carte gaming suffit-elle ?
Oui pour débuter et pour un usage individuel : la RTX 5090 est même aussi rapide qu'une RTX PRO 6000 sur les modèles qui tiennent dans ses 32 Go. Les cartes RTX PRO apportent 3× plus de mémoire, l'ECC et une fiabilité 24 h/24.
AMD ou Intel pour le processeur ?
Avec un seul GPU, un Ryzen 9 ou un Core Ultra suffit. Dès 2 GPU ou si vous faites tourner des modèles en partie sur la RAM, une plateforme Threadripper (PRO) ou Xeon W s'impose pour ses lignes PCIe et ses 4 à 8 canaux mémoire.
Peut-on faire évoluer la machine plus tard ?
Oui, c'est l'avantage d'une workstation : on commence avec un GPU et on en ajoute un second, ou plus de RAM, quand les besoins grandissent. Nos plateformes Threadripper et Xeon W sont prévues pour cela.
Où acheter un PC pour l'IA près de Toulouse ?
Forge PC Elite assemble des workstations IA à Labège (31). Utilisez le configurateur PC Pro – IA ou demandez un devis personnalisé.
La bonne machine,
ni plus, ni moins.
Décrivez vos usages, vos modèles et votre budget : Forge PC Elite vous propose la configuration la plus juste, assemblée et testée à Labège.