Au-delà du GPU :
les puces de l'IA de demain
Puces géantes, NPU, processeurs qui calculent avec la lumière ou imitent les neurones : le matériel de l'IA vit sa plus grande révolution depuis l'invention du microprocesseur. Voyage au cœur du silicium.
- Le GPU domine l'IA depuis 2012 grâce à ses milliers de cœurs parallèles et à l'écosystème CUDA de NVIDIA. Il restera la référence pendant des années.
- Le vrai goulot d'étranglement n'est plus le calcul mais la mémoire : déplacer les données coûte plus de temps et d'énergie que les traiter. D'où la course à la HBM et à l'empilement 3D.
- Des puces spécialisées (TPU, NPU, ASIC d'inférence) font mieux sur des tâches précises, mais au prix de la souplesse.
- La photonique arrive d'abord dans les connexions entre puces ; le neuromorphique et l'analogique promettent des gains d'efficacité spectaculaires, encore en laboratoire.
- Pour un PC IA, la règle ne change pas : VRAM et bande passante d'abord. Les NPU des portables gèrent les petites tâches, le GPU fait le gros du travail.
Calculer est devenu facile.
Nourrir le calcul, non.
En dix ans, la puissance de calcul des puces d'IA a été multipliée par des milliers, tandis que la vitesse de la mémoire progressait bien plus lentement. Pour écrire chaque mot, un modèle de langage doit relire tous ses paramètres : c'est la bande passante qui fixe le rythme.
de transistors dans un GPU NVIDIA B200 (2024), assemblé à partir de deux puces
de transistors sur le Cerebras WSE-3, une puce grande comme une galette de silicium entière
de bande passante mémoire sur une RTX 5090, contre environ 90 Go/s pour la RAM d'un PC
de neurones artificiels dans Hala Point, le système neuromorphique d'Intel (2024)
Ouvrez une puce d'IA
couche par couche
Un accélérateur moderne n'est plus une puce unique mais un assemblage en 3D, appelé « packaging avancé ». Survolez la maquette pour l'éclater.
Huit architectures en compétition
Du GPU universel au processeur qui calcule avec des photons, chaque famille fait un pari différent entre souplesse, puissance et sobriété.
GPU
Des milliers de cœurs parallèles et des cœurs tensoriels dédiés aux matrices. Programmable pour tout : entraînement, inférence, image, vidéo, simulation.
Sur votre bureau : déjà là : c'est le cœur de tout PC IA.
TPU & ASIC
Des puces conçues pour une seule chose : les réseaux de neurones. Google en est à sa 7e génération de TPU (Ironwood, 192 Go de HBM).
Sur votre bureau : non, réservé aux clouds, mais ces puces font baisser le prix des IA en ligne.
NPU
Un petit accélérateur intégré au processeur, très sobre, pour les tâches IA permanentes : flou d'arrière-plan, transcription, recherche locale.
Sur votre bureau : déjà là (40 à 55 TOPS), mais trop limité pour les grands modèles.
Wafer-scale
Plutôt que de découper la galette de silicium en puces, Cerebras la garde entière : 900 000 cœurs et 44 Go de mémoire SRAM sur une seule puce.
Sur votre bureau : non, mais vous l'utilisez peut-être via des services d'inférence ultra-rapides.
Photonique
Remplacer les électrons par des photons pour transporter, voire calculer les données. D'abord dans les liens entre puces (optique co-intégrée), ensuite dans le calcul.
Sur votre bureau : d'ici 2030 pour les liens réseau des data centers ; plus tard pour le calcul.
Neuromorphique
Des puces qui imitent les neurones et ne consomment que lorsqu'un « influx » circule. Des gains d'énergie énormes sur certaines tâches.
Sur votre bureau : capteurs, robots et objets connectés d'abord, au-delà de 2030.
Calcul en mémoire
Faire les multiplications directement dans les cellules mémoire, avec des courants électriques, pour supprimer les allers-retours de données.
Sur votre bureau : premiers modules embarqués ; les PC attendront.
Quantique
Pas une puce d'IA, mais un partenaire : les processeurs quantiques s'attaqueront à la chimie et à l'optimisation, pilotés par des GPU.
Sur votre bureau : non, mais votre GPU peut déjà le simuler.
Envie d'aller plus loin sur le quantique ? Notre dossier IA & ordinateur quantique vous permet de manipuler un qubit et de simuler un processeur quantique sur GPU.
Du 4004 aux puces de lumière :
55 ans de silicium
Faites défiler horizontalement. En pointillés : nos projections, avec leur degré de probabilité.
Intel 4004
Le premier microprocesseur commercial : 2 300 transistors.
GeForce 256
NVIDIA lance ce qu'elle baptise le premier « GPU ».
CUDA
Les cartes graphiques deviennent programmables pour le calcul scientifique.
AlexNet
Un réseau de neurones entraîné sur deux GeForce GTX 580 révolutionne la vision par ordinateur : l'IA moderne est née sur des cartes de joueurs.
TPU
Google dévoile sa première puce dédiée aux réseaux de neurones.
Tensor Cores
Des cœurs spécialisés dans les multiplications de matrices apparaissent dans les GPU.
H100
80 milliards de transistors : le GPU qui a entraîné la vague ChatGPT.
B200 · WSE-3
208 milliards de transistors chez NVIDIA, 4 000 milliards sur la puce géante de Cerebras.
Rubin · HBM4
Mémoire HBM4, gravure 3 nm, 288 Go par GPU. La gravure 2 nm entre en production.
Optique co-intégrée
Les liens entre puces passent massivement à la lumière dans les data centers.
Probabilité estimée : 80 %
Puces empilées en 3D
Mémoire et calcul superposés pour franchir le mur de la mémoire.
Probabilité estimée : 70 %
PC à 1 To unifié
Des workstations avec un téraoctet de mémoire accessible au GPU.
Probabilité estimée : 55 %
Neuromorphique embarqué
Robots et capteurs pensent localement avec quelques watts.
Probabilité estimée : 45 %
Calcul photonique
Des accélérateurs qui calculent directement avec la lumière.
Probabilité estimée : 30 %
Le PC IA de 2030 ressemblera à…
Mémoire unifiée géante
CPU, GPU et NPU partageant des centaines de gigaoctets, comme sur les superpuces des data centers.
Un NPU toujours actif
Pour les agents qui tournent en arrière-plan sans réveiller le GPU.
Un GPU pour les gros calculs
Génération vidéo, grands modèles, fine-tuning : la VRAM restera reine.
Un accès au quantique
Via le cloud, pour la chimie et l'optimisation, piloté depuis votre poste.
En attendant, les principes pour bien choisir restent les mêmes : lisez notre guide Quel PC pour l'IA ? et suivez les actualités hardware IA.
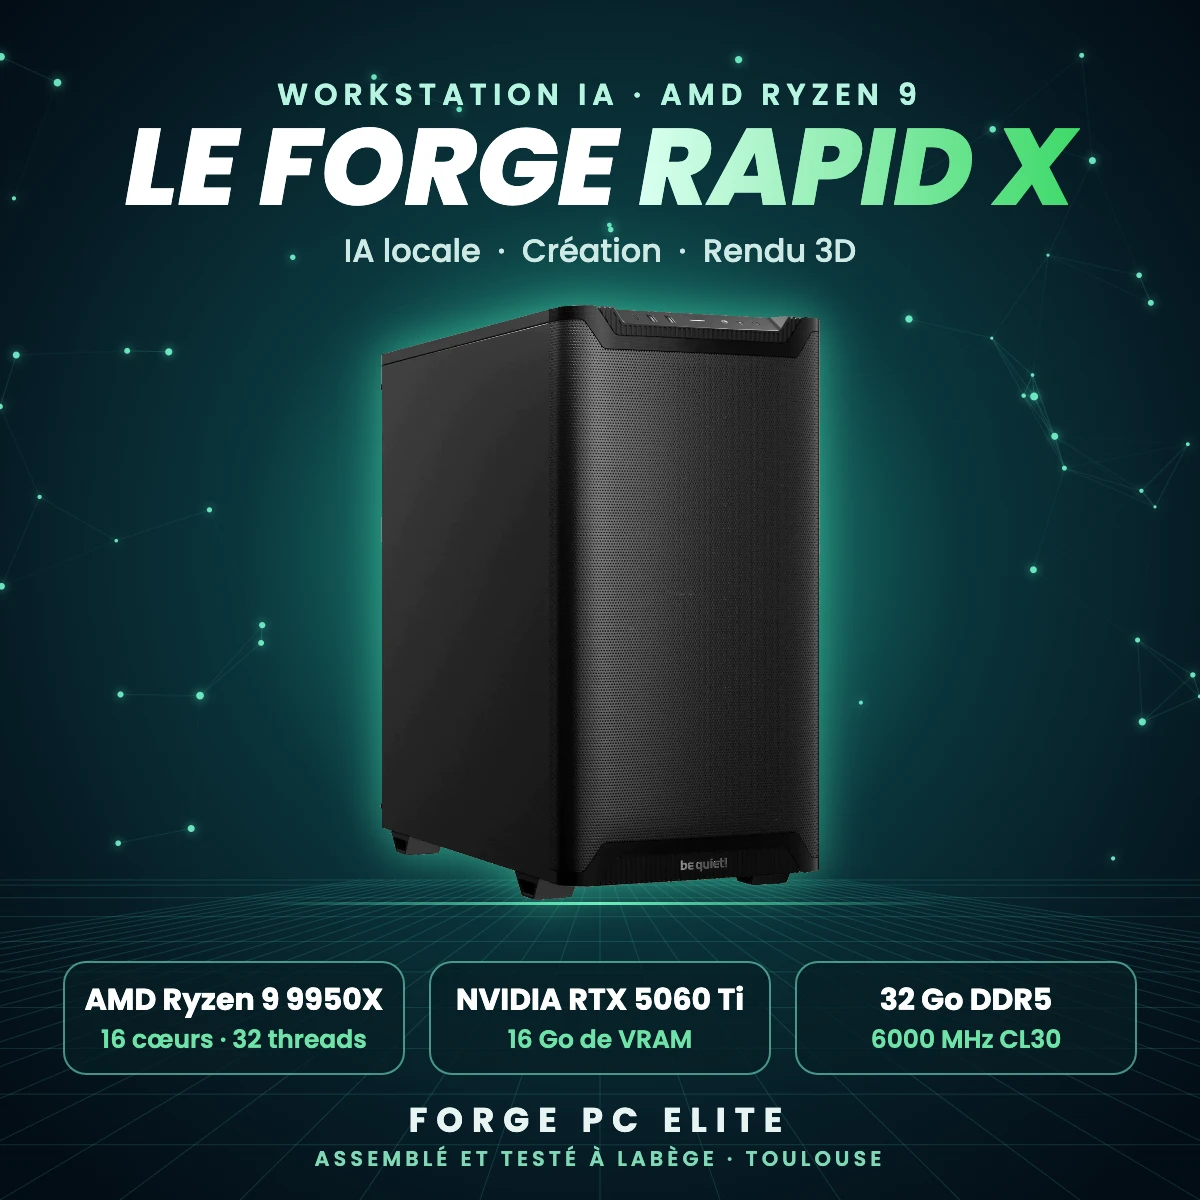
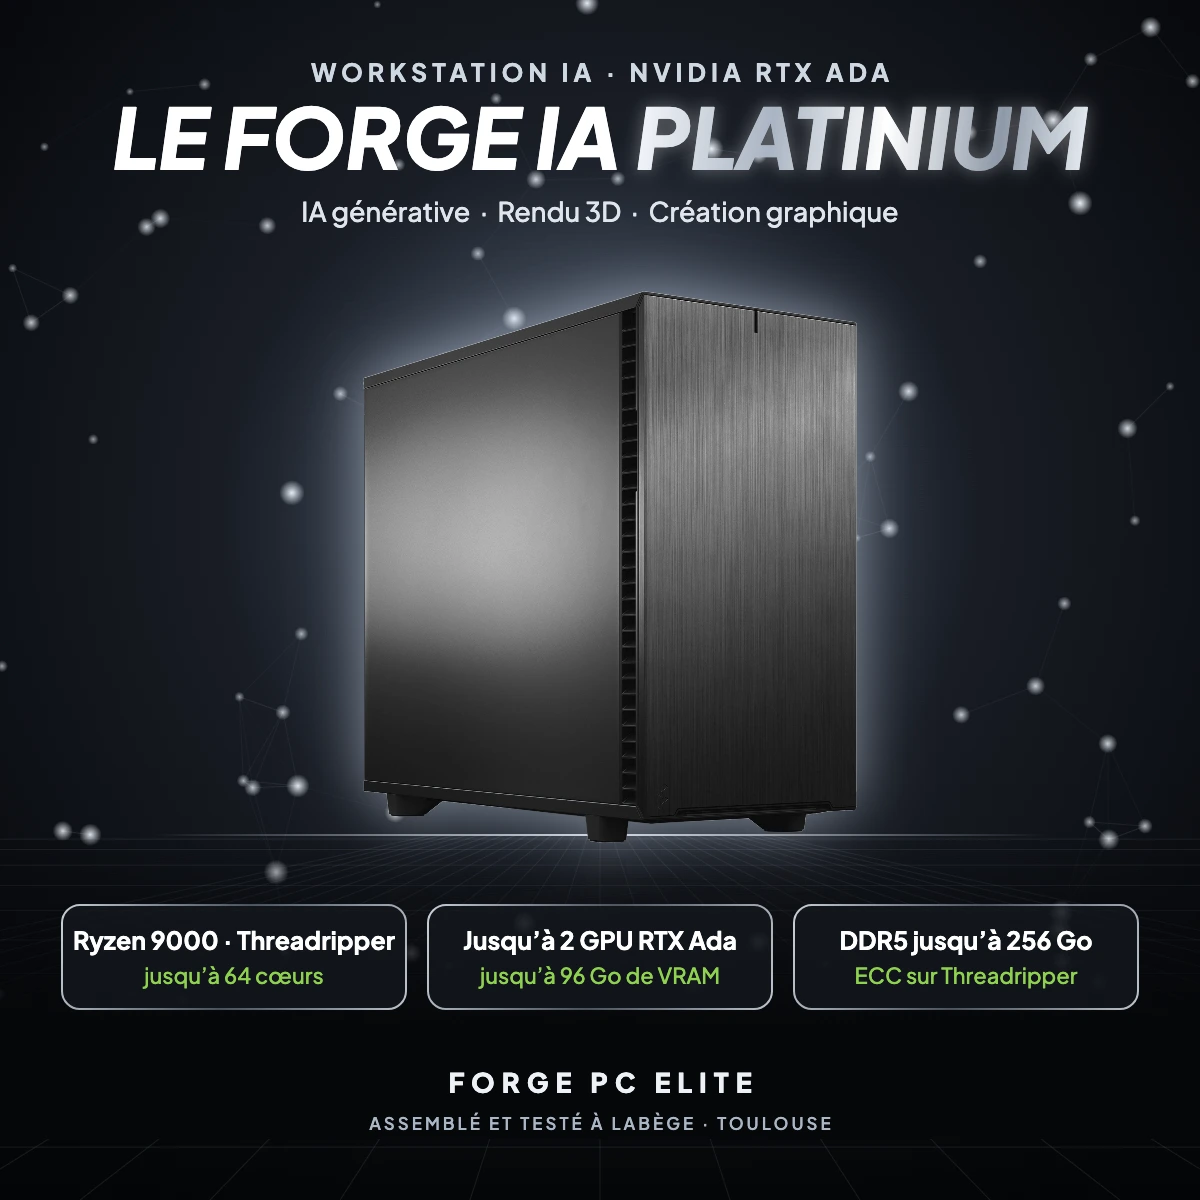
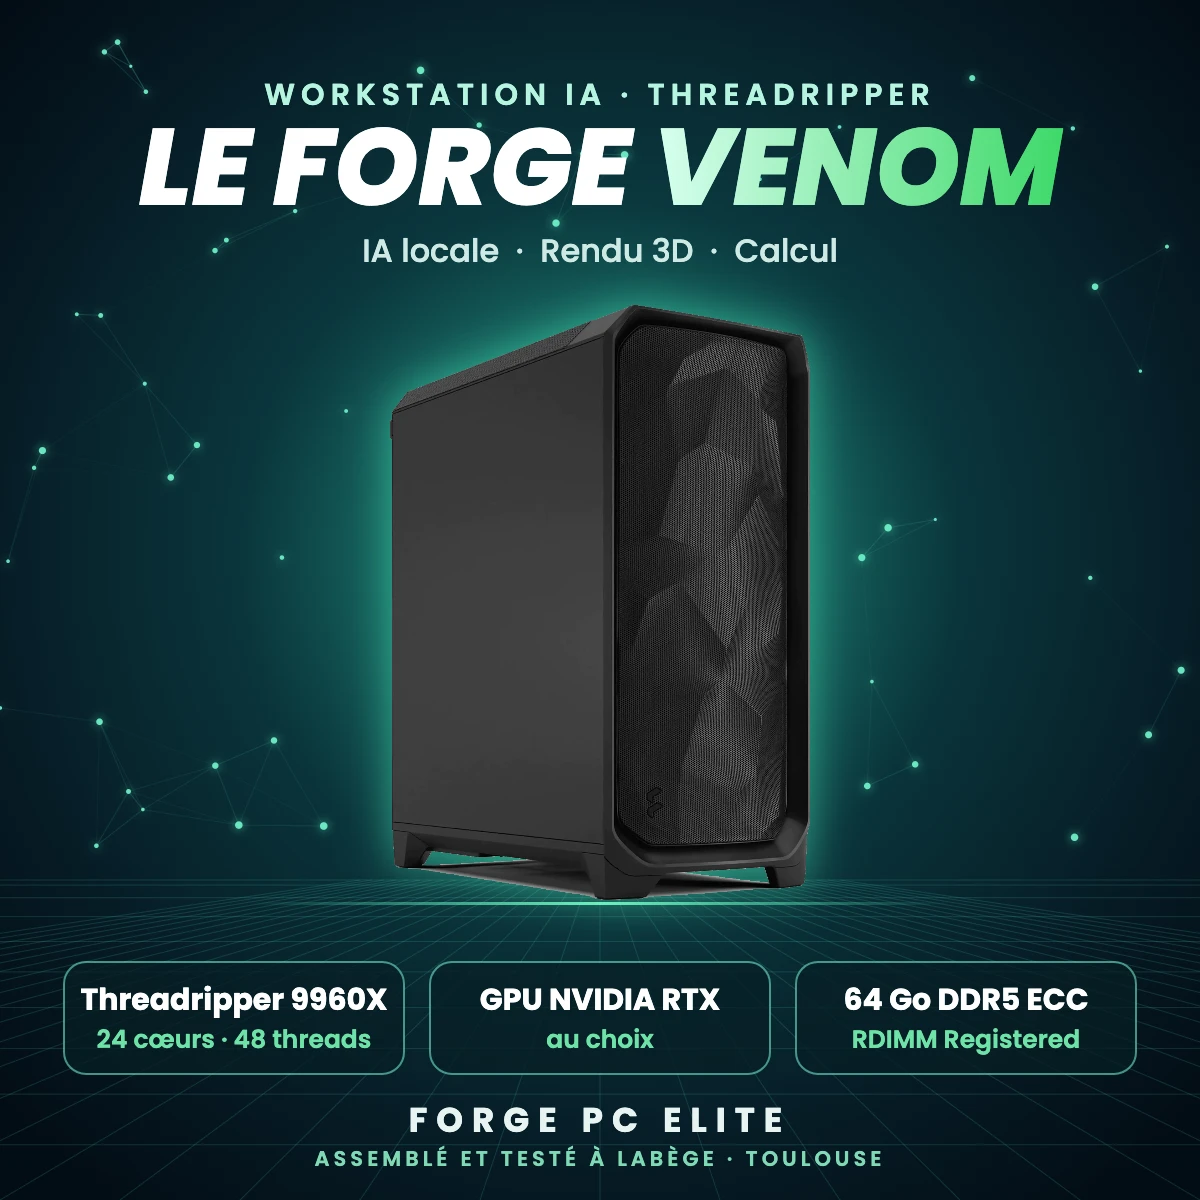
Les meilleures puces d'IA du moment, assemblées à Labège.
RTX 5090, RTX PRO 6000 Blackwell, Threadripper PRO : nos workstations embarquent les puces qui font tourner l'IA locale, testées sous charge et livrées prêtes à l'emploi.
Puces d'IA : vos questions
Le GPU va-t-il être remplacé pour l'IA ?
Pas avant longtemps. Les puces spécialisées gagnent du terrain dans les data centers, mais le GPU reste le seul accélérateur à la fois puissant, programmable et soutenu par tous les logiciels d'IA. Pour un PC d'IA locale, c'est la pièce maîtresse.
Un NPU suffit-il pour faire tourner une IA locale ?
Pour de petites tâches (transcription, retouche, petits modèles de 1 à 3 milliards de paramètres), oui. Pour un vrai assistant ou la génération d'images, il faut une carte graphique avec au moins 16 Go de VRAM.
Qu'est-ce que la HBM ?
La High Bandwidth Memory est une mémoire DRAM empilée en couches et posée juste à côté du processeur. Elle atteint plusieurs téraoctets par seconde, mais elle est chère et réservée aux accélérateurs de data center.
Qu'est-ce qu'une puce neuromorphique ?
Une puce qui imite le fonctionnement des neurones biologiques : elle ne calcule que lorsqu'un signal arrive, ce qui la rend extrêmement économe. Intel (Loihi 2, Hala Point) et IBM (NorthPole) en sont les pionniers.
Faut-il attendre les nouvelles puces pour acheter un PC IA ?
Non. Les révolutions décrites ici arriveront d'abord dans les data centers. Une workstation bien dimensionnée en VRAM aujourd'hui restera utile plusieurs années, d'autant que les modèles deviennent plus efficaces chaque année.
À lire aussi : IA & quantique · L'avenir de l'IA · IA & énergie · La chronologie de l'IA.